
7.4 도로명주소 유효성 평가 & 정제
이번 장에서는 공공데이터에 존재하는 도로명주소 데이터의 유효성을 평가하고, 오류 데이터를 정제하는 방법들을 설명한다. 이 장에서 사용된 샘플 공공데이터의 원본은 전국공공시설개방정보표준데이터이며, 행정동별 인구현황 데이터는 행정동별 주민등록 인구 및 세대현황을 사용했다.
이 장에서 사용하는 데이터와 코드 원본은 아래 링크에서 확인할 수 있다.
평가 테이블 만들기
먼저 셀값의 오류를 저장하기 위해 addr_error이라는 새로운 테이블을 생성한다.
구문 오류를 검사하고 광역자치단체명의 축약 여부, API 검색 가능 여부를 확인하기 위한 컬럼을 추가하고 향후 데이터 정제를 위해 검색된 주소를 기록하는 컬럼을 새로 생성한다.
datalength = len(df) # 전체 행의 길이
addr_error = pd.DataFrame(np.zeros((datalength, 4)),
    columns=["pattern","unvalid_city","exist","API_addr"])
addr_error["data"] = df['소재지도로명주소'] # 확인을 위한 원본 데이터오류유형 패턴을 통한 유효성 평가
정규표현식을 활용하여 오류유형 패턴에 해당하는 주소들을 탐색하고, 정제할 수 있다. 다음은 행정구역별로 오류 유형을 탐색하는 패턴 규칙을 나타내는 표이다.
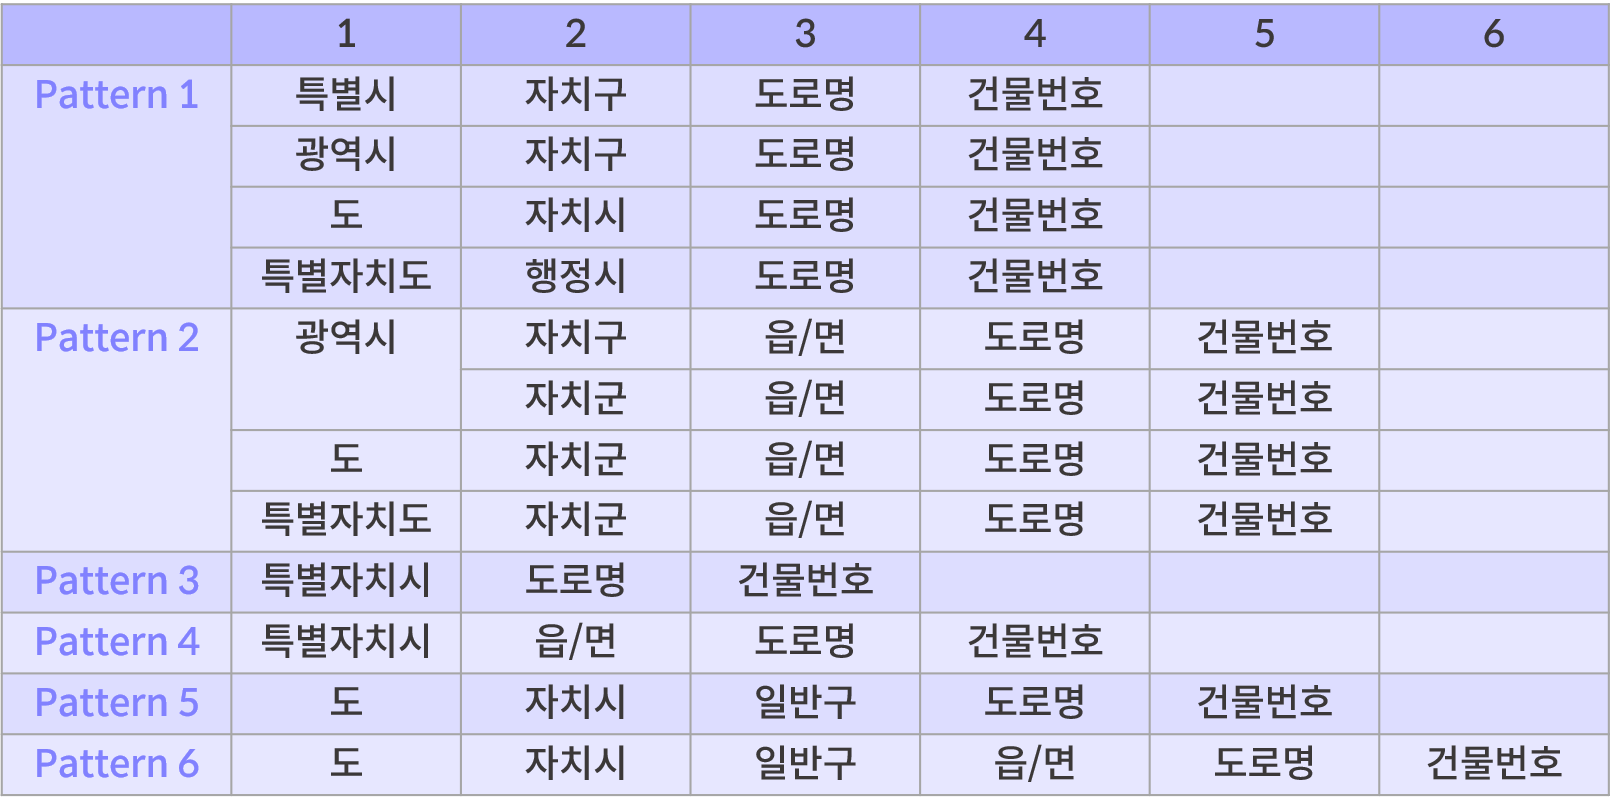
위의 표에 있는 주소 구성요소 규칙에 따라 유효성을 점검하고 주소를 직접 수정할 수 있다.
주소의 유효성 평가하기
아래는 표에 제시된 패턴 규칙을 구현한 정규표현식 코드이다.
# 특별/광역시/특별자치도/도 + 구/자치시/행정시 + 도로명 + 건물번호
pattern1 = r"(?P<province>[가-힣]+)(?:특별시|광역시|특별자치도|도)\s+(?P<city>[가-힣]+)(시|구)\s+(?P<road>[가-힣\d]+)(?:로|길)\s+(?P<number>[\d])"

# 광역시/도/특별자치도 + 자치구/군 + 읍/면 + 도로명 + 건물번호
pattern2 = r"(?P<province>[가-힣]+)(?:도|광역시|특별자치도)\s+(?P<city>[가-힣]+)(시|군|구)\s+(?P<local>[가-힣]+)(읍|면)\s+(?P<road>[가-힣\d]+)(?:로|길)\s+(?P<number>[\d])"

# 특별자치시 + 읍/면 + 도로명 + 건물번호
pattern3 = r"(?P<province>[가-힣]+)(?:특별자치시)\s+(?P<type>[가-힣]+)(?:읍|면)\s+(?P<road>[가-힣\d]+)(?:로|길)\s+(?P<number>[\d])"

# 특별자치시 + 도로명 + 건물번호
pattern4 = r"(?P<province>[가-힣]+)(?:특별자치시)\s+(?P<road>[가-힣\d]+)(?:로|길)\s+(?P<number>[\d])"

# 특별자치도/도 + 자치/행정시 + 일반구 + 도로명 + 건물번호
pattern5 = r"(?P<province>[가-힣]+)(?:도|특별자치도)\s+(?P<city>[가-힣]+)(?:시)\s+(?P<type>[가-힣]+)(?:구)\s+(?P<road>[가-힣\d]+)(?:로|길)\s+(?P<number>[\d])"

# 특별자치도/도 + 자치/행정시 + 일반구 + 읍/면 + 도로명 + 건물번호
pattern6 = r"(?P<province>[가-힣]+)(?:도|특별자치도)\s+(?P<city>[가-힣]+)(?:시)\s+(?P<type>[가-힣]+)(?:구)\s+(?P<local>[가-힣]+)(?:읍|면)\s+(?P<road>[가-힣\d]+)(?:로|길)\s+(?P<number>[\d])"위의 패턴들을 적용해 구문오류를 탐색하고 특별시/광역시/특별자치도/특별자치시와 같은 광역자치단체명의 오류를 검토한다. 이 과정들을 모두 반영하여 주소의 구문 오류를 탐색하는 함수를 작성하면 아래의 코드와 같다.
def element_check(i):
    item = df['소재지도로명주소'][i]
    if item != None:
        # 패턴을 통한 구문 오류 체크
        if re.match(pattern1, item) or re.match(pattern2, item) or re.match(pattern3, item) or re.match(pattern4, item) or re.match(pattern5, item) or re.match(pattern6, item):
            addr_error["pattern"][i] = 0

        else:
            addr_error["pattern"][i] = 1

        # 축약된 광역자치단체명 체크
        sido = df['소재지도로명주소'][i].split(" ")[0]
        print(sido)
        if sido in sido_map.keys():
            addr_error["unvalid_city"][i] = 1
        else:
            addr_error["unvalid_city"][i] = 0
    # 공백값
    else:
        addr_error["pattern"][i] = None
        addr_error["unvalid_city"][i] = None

df.index.map(lambda i: element_check(i))오류 주소의 비율은 어느정도 되는지, 또 오류가 발생한 행은 주로 어디에 있는지 plotly 라이브러리를 활용하여 시각화한다.
import plotly.graph_objects as go
from plotly.subplots import make_subplots

def make_error_rate_plot(addr_error):
    # colors
    # 정상 : darkblue, 오류 : darkred, 공백 : lightgrey
    COLORS = ["darkblue", "darkred", "lightgrey"]

    # 오류 비중 계산

    errors = addr_error["pattern"].value_counts()[1]
    normal = addr_error["pattern"].value_counts()[0]
    blank = len(df) - errors - normal

    # 서브플롯 객체 생성
    # 히트맵을 위해 2개 컬럼에 걸쳐 히트맵 plot 배정
    fig = make_subplots(rows=1, cols=3,
                        specs=[[{'type':'pie'}, {"colspan": 2}, None]],
                        subplot_titles=("오류 데이터 비율","오류 행 현황"))

    # 파이차트 추가
    fig.add_trace(go.Pie(labels=['정상','오류','공백'], textinfo='label+percent',
                        values=[normal, errors, blank],marker=dict(colors=COLORS), showlegend=False,),
                row=1, col=1)
    # 히트맵차트 추가
    fig.add_trace(go.Heatmap(z=[addr_error['pattern']], x = list(addr_error.index), y= ["error row # "],
                            colorscale = [[0, "darkblue"],[1, "darkred"]]), row=1, col=2)

    fig.show()
return fig대략 5%의 주소에 구문 오류가 있다.
유효하지 않은 주소 정제하기
이제 오류 행만 추출해서 정제할 수 있다.
정제는 오류 패턴별 정규표현식을 적용하여 수정하는데, 이 과정은 한 유형씩 순차적으로 진행된다.
각 과정에 해당하는 정규표현식과 전체 코드가 매우 길고 복잡한 관계로, 코드는 파이썬 노트북 파일에서만 설명한다.
정제가 완료된 후, 앞선 구문 유효성 체크 함수를 다시 실행시켜보면 아래와 같은 그래프를 얻을 수 있다.
API를 통한 유효성 평가 & 정제
API를 통한 주소의 실존 여부에 대한 확인 과정에서는, 추후 행정동별 인구 데이터와의 통합을 위해, 검색된 주소의 행정동 요소도 별도로 저장한다.
실존하지 않는 주소 탐색하기
갱신, 폐지되었거나 오기입이 있는 주소를 API를 통해 파악한다. 이 과정에서는 주소를 검색할 수 있는 API 검색 함수 search_addr를 생성해 활용한다.
# 주소 검색 함수
def search_addr(addr):
    # 요청 헤더에는 API 키와 아이디 값을 입력
    headers = {"X-NCP-APIGW-API-KEY-ID":API_ID, "X-NCP-APIGW-API-KEY":API_SECRET}

    # 파라미터에는 검색할 주소를 입력
    params = {"query" : addr, "output":"json"}

    # 정보를 요청할 url
    url ="https://naveropenapi.apigw.ntruss.com/map-geocode/v2/geocode"

    data = requests.get(url, headers=headers, params=params)

return json.loads(data.text)search_addr함수를 이용해 도로명주소의 실존 여부를 확인하는 코드는 아래와 같다. 응답값의 검색 결과 개수를 기준으로 존재 여부를 체크한다.
주소가 존재할 경우, 추후 인구데이터와의 병합키를 만들기 위해 동명칭을 검색 결과에서 추출해 addr_error테이블의 API_addr에 추가한다.
for i in tqdm(range(len(df))):
    if df['소재지도로명주소'][i] != None:
        re_val = search_addr(df.loc[i, "소재지도로명주소"])

        # 검색한 주소가 존재하는지 확인
        if (re_val["status"] != "OK") or (re_val["meta"]["totalCount"] == 0):
            addr_error['exist'][i] = 1
            addr_error['API_addr'][i] = None

        else:
            if re_val["status"] == "OK":
                addr_error['exist'][i] = 0

                # 동명칭을 추가
                dong = re_val['addresses'][0]["addressElements"][2]["longName"]
                addr_error['API_addr'][i] = dong
    else:
        addr_error['exist'][i] = None
addr_error['API_addr'][i] = None결과를 make_error_rate_plot함수로 시각화하면 다음과 같다.
존재하지 않는 주소는 좌표계 데이터로 정제하기
샘플 데이터에는 좌표계 데이터가 존재한다. 존재하지 않는 도로명주소들에 대해서는 좌표계 데이터를 통한 주소 검색으로 나온 결과값으로 수정한다.
먼저 정제할 행들을 추출해 idx라는 리스트에 넣는다. 이번에는 도로명주소 컬럼의 결측 행도 포함시킨다.
idx = addr_error[addr_error["exist"]==1].index.tolist()
idx += addr_error[addr_error["exist"].isnull()].index.tolist()search_coords는 좌표계를 통해 도로명주소를 검색하는 함수이다. 앞서 도로명주소를 검색하는 함수와 유사하나, 요청 URL과 요청값이 다르다.
# 경도, 위도 순으로 입력
def search_coords(x,y):
    coord = f"{x},{y}"
    # 요청 헤더에는 API 키와 아이디 값을 입력
    headers = {"X-NCP-APIGW-API-KEY-ID":API_ID, "X-NCP-APIGW-API-KEY":API_SECRET}

    # 파라미터에는 변환할 좌표계를 입력 -> "경도,위도" 순으로 입력
    params = {"coords" : coord, "output":"json", "orders":"roadaddr,addr"}

    # 정보를 요청할 url
    url ="https://naveropenapi.apigw.ntruss.com/map-reversegeocode/v2/gc"

    data = requests.get(url, headers=headers, params=params)

return json.loads(data.text)road_addr_maker는 API에서 리턴된 주소 구성 요소들을 합성해 도로명주소로 만들어주는 함수이다. 주소 구문 유형에 따라 다르게 구성요소를 통합한다.
# 도로명주소를 합성하는 함수
def road_addr_maker(road_obj):
    road = road_obj["region"]["area1"]["name"] + " " + road_obj["region"]["area2"]["name"]
    if road_obj["region"]["area3"]["name"][-1] == "읍" or road_obj["region"]["area3"]["name"][-1] == "면":
        road += " " + road_obj["region"]["area3"]["name"]
    if road_obj["land"]["name"] != "":
        road += " " + road_obj["land"]["name"]
    if road_obj["land"]["number1"] != "":
        road += " " + road_obj["land"]["number1"]
    if  road_obj["land"]["number2"] != "":
        road += "-" + road_obj["land"]["number2"]
    return road

# 지번주소 합성 함수 (본 챕터에서 사용 X)
def addr_maker(addr_obj):
    addr = addr_obj["region"]["area1"]["name"] + " " + addr_obj["region"]["area2"]["name"] + " " + addr_obj["region"]["area3"]["name"]
    if addr_obj["region"]["area4"]["name"] != "":
        addr += " " + addr_obj["region"]["area4"]["name"]
    if addr_obj["land"]["type"] == "1":
        addr += " " + addr_obj["land"]["number1"]
    if addr_obj["land"]["type"] == "2":
        addr += " " + addr_obj["land"]["number1"]+"-"+addr_obj["land"]["number2"]
return addr이제 앞서 만든 함수들을 활용해서 도로명주소를 정제할 수 있다. non_exist_coord에는 검색 결과가 존재하지 않는 좌표계의 행 번호를 저장한다.
# 좌표계 데이터 역시 잘못된 경우 저장
non_exist_coord = []

for i in tqdm(idx):
        # 좌표계 검색
        re_val = search_coords(df.loc[i, "경도"],df.loc[i, "위도"])

        # 검색한 좌표계가 존재하는지 확인
        if (re_val["status"]["name"] != "ok") or (len(re_val["results"]) == 0):
            non_exist_coord.append(i)

        # 검색한 좌표계가 존재하는 경우
        else:
            # 도로명주소가 모두 존재하는 지점인 경우
            if len(re_val["results"]) == 2:
                road_obj = re_val["results"][0]

                # 주소 합성
                road = road_addr_maker(road_obj)
df['소재지도로명주소'][i] = roadnon_exist_coord에는 668행만 존재한다. 668번행의 데이터의 경우, 주소 검색 과정에서 실존하는 주소임을 확인했으므로, 모든 도로명주소가 유효한 값을 갖게 되었다는 것을 확인할 수 있다.
데이터 통합
INFO
샘플 데이터와 병합할 인구데이터 원본은 행정동/읍/면 단위로 집계되어 있으며, 출장소나 광역지방자치단체, 기초지방자치단체 단위의 합산값도 포함되어 있다. 이번 프로젝트에서는 행정동이 아닌 법정동을 기준으로 집계하며, 출장소나 시/군/구 단위 집계치는 제외된 상태의 정제된 데이터를 활용한다.
먼저 도로명주소 컬럼의 데이터를 활용해 인구 데이터와 합치기 위한 키 컬럼을 만든다.
인구데이터 파일과 법정동별로 병합이 필요한 지역에 대한 파일은 7-4_dong_merge_table.json이다. 이후 과정의 진행을 위해 해당 파일을 다운받아야 한다.
앞선 과정에서 API로 주소데이터를 점검함과 동시에 법정동에 대한 정보도 함께 저장했는데, 이번에는 인구데이터의 법정동과 도로명주소의 법정동을 key 값으로 두 데이터를 통합한다.
census = pd.read_excel("census_data_cleaned.xlsx") # 인구 데이터
merge_table = json.load(open("dong_merge_table.json", "r")) # 동 명칭 병합이 필요한 테이블
merge_table = merge_table["data"]
change_list = list(merge_table.keys()) # 법정동끼리 병합이 필요한 지역

# 복수의 법정동이 합산되어 집계된 지역
def mergeing_dong(i):
    if df['소재지도로명주소'][i] != None:
        addr_splits = df['소재지도로명주소'][i].split(" ")

        city = addr_splits[0] + " " + addr_splits[1]
        if addr_error["API_addr"][i] in change_list and city == merge_table[addr_error["API_addr"][i]]["city"]:
            addr_error["API_addr"][i] = merge_table[addr_error["API_addr"][i]]["changeto"]

addr_error.index.map(lambda i: mergeing_dong(i))이제 법정동을 기준으로 두 데이터를 합친다. 먼저, 행정기관명을 조합하여 키 컬럼을 만든다.
census["key"] = census['행정기관']
df["동명칭"] = addr_error["API_addr"]
def key_make(i):
    if df['소재지도로명주소'][i] != None:
        key_match = re.search(r"[가-힣]+(?P<city>특별시|광역시|특별자치도|도|특별자치시)+(\s[가-힣]+(?P<city2>(?:시|군|구)))?+(\s[가-힣]+(?P<local>구))?", df['소재지도로명주소'][i])
        if key_match != None and type(df['동명칭'][i]) == str:
            return df['소재지도로명주소'][i][key_match.span()[0]: key_match.span()[1]] + " " + df["동명칭"][i]
        else:
            return None
    else:
        if df['소재지지번주소'][i] != None:
            key_match = re.search(r"[가-힣]+(?P<city>특별시|광역시|특별자치도|도|특별자치시)+(\s[가-힣]+(?P<city2>(?:시|군|구)))?+(\s[가-힣]+(?P<local>구))?", df['소재지지번주소'][i])
            if key_match != None and type(df['동명칭'][i]) == str:
                return df['소재지지번주소'][i][key_match.span()[0]: key_match.span()[1]]+ " " + df["동명칭"][i]
            else:
                return None
df["key"] = df.index.map(lambda i: key_make(i))이제 생성된 키 컬럼을 기준으로 두 데이터를 합칠 수 있다.
merged = pd.merge(left = df, right = census, on="key", how="left")합쳐진 데이터를 저장한다. 다음 챕터에서는 이렇게 합친 데이터의 품질을 평가하는 방법에 대해 알아본다.
# 사용하지 않을 컬럼은 제외
merged.drop(["동명칭", "key"], axis = 1, inplace = True)
merged.to_excel("merged_clean.xlsx", index=False)