
4.5 주소 데이터 활용하기
4.5에서는 인구데이터와 면적데이터를 추가로 활용하여 도로명주소 데이터를 살펴보고 지도시각화를 진행한다.
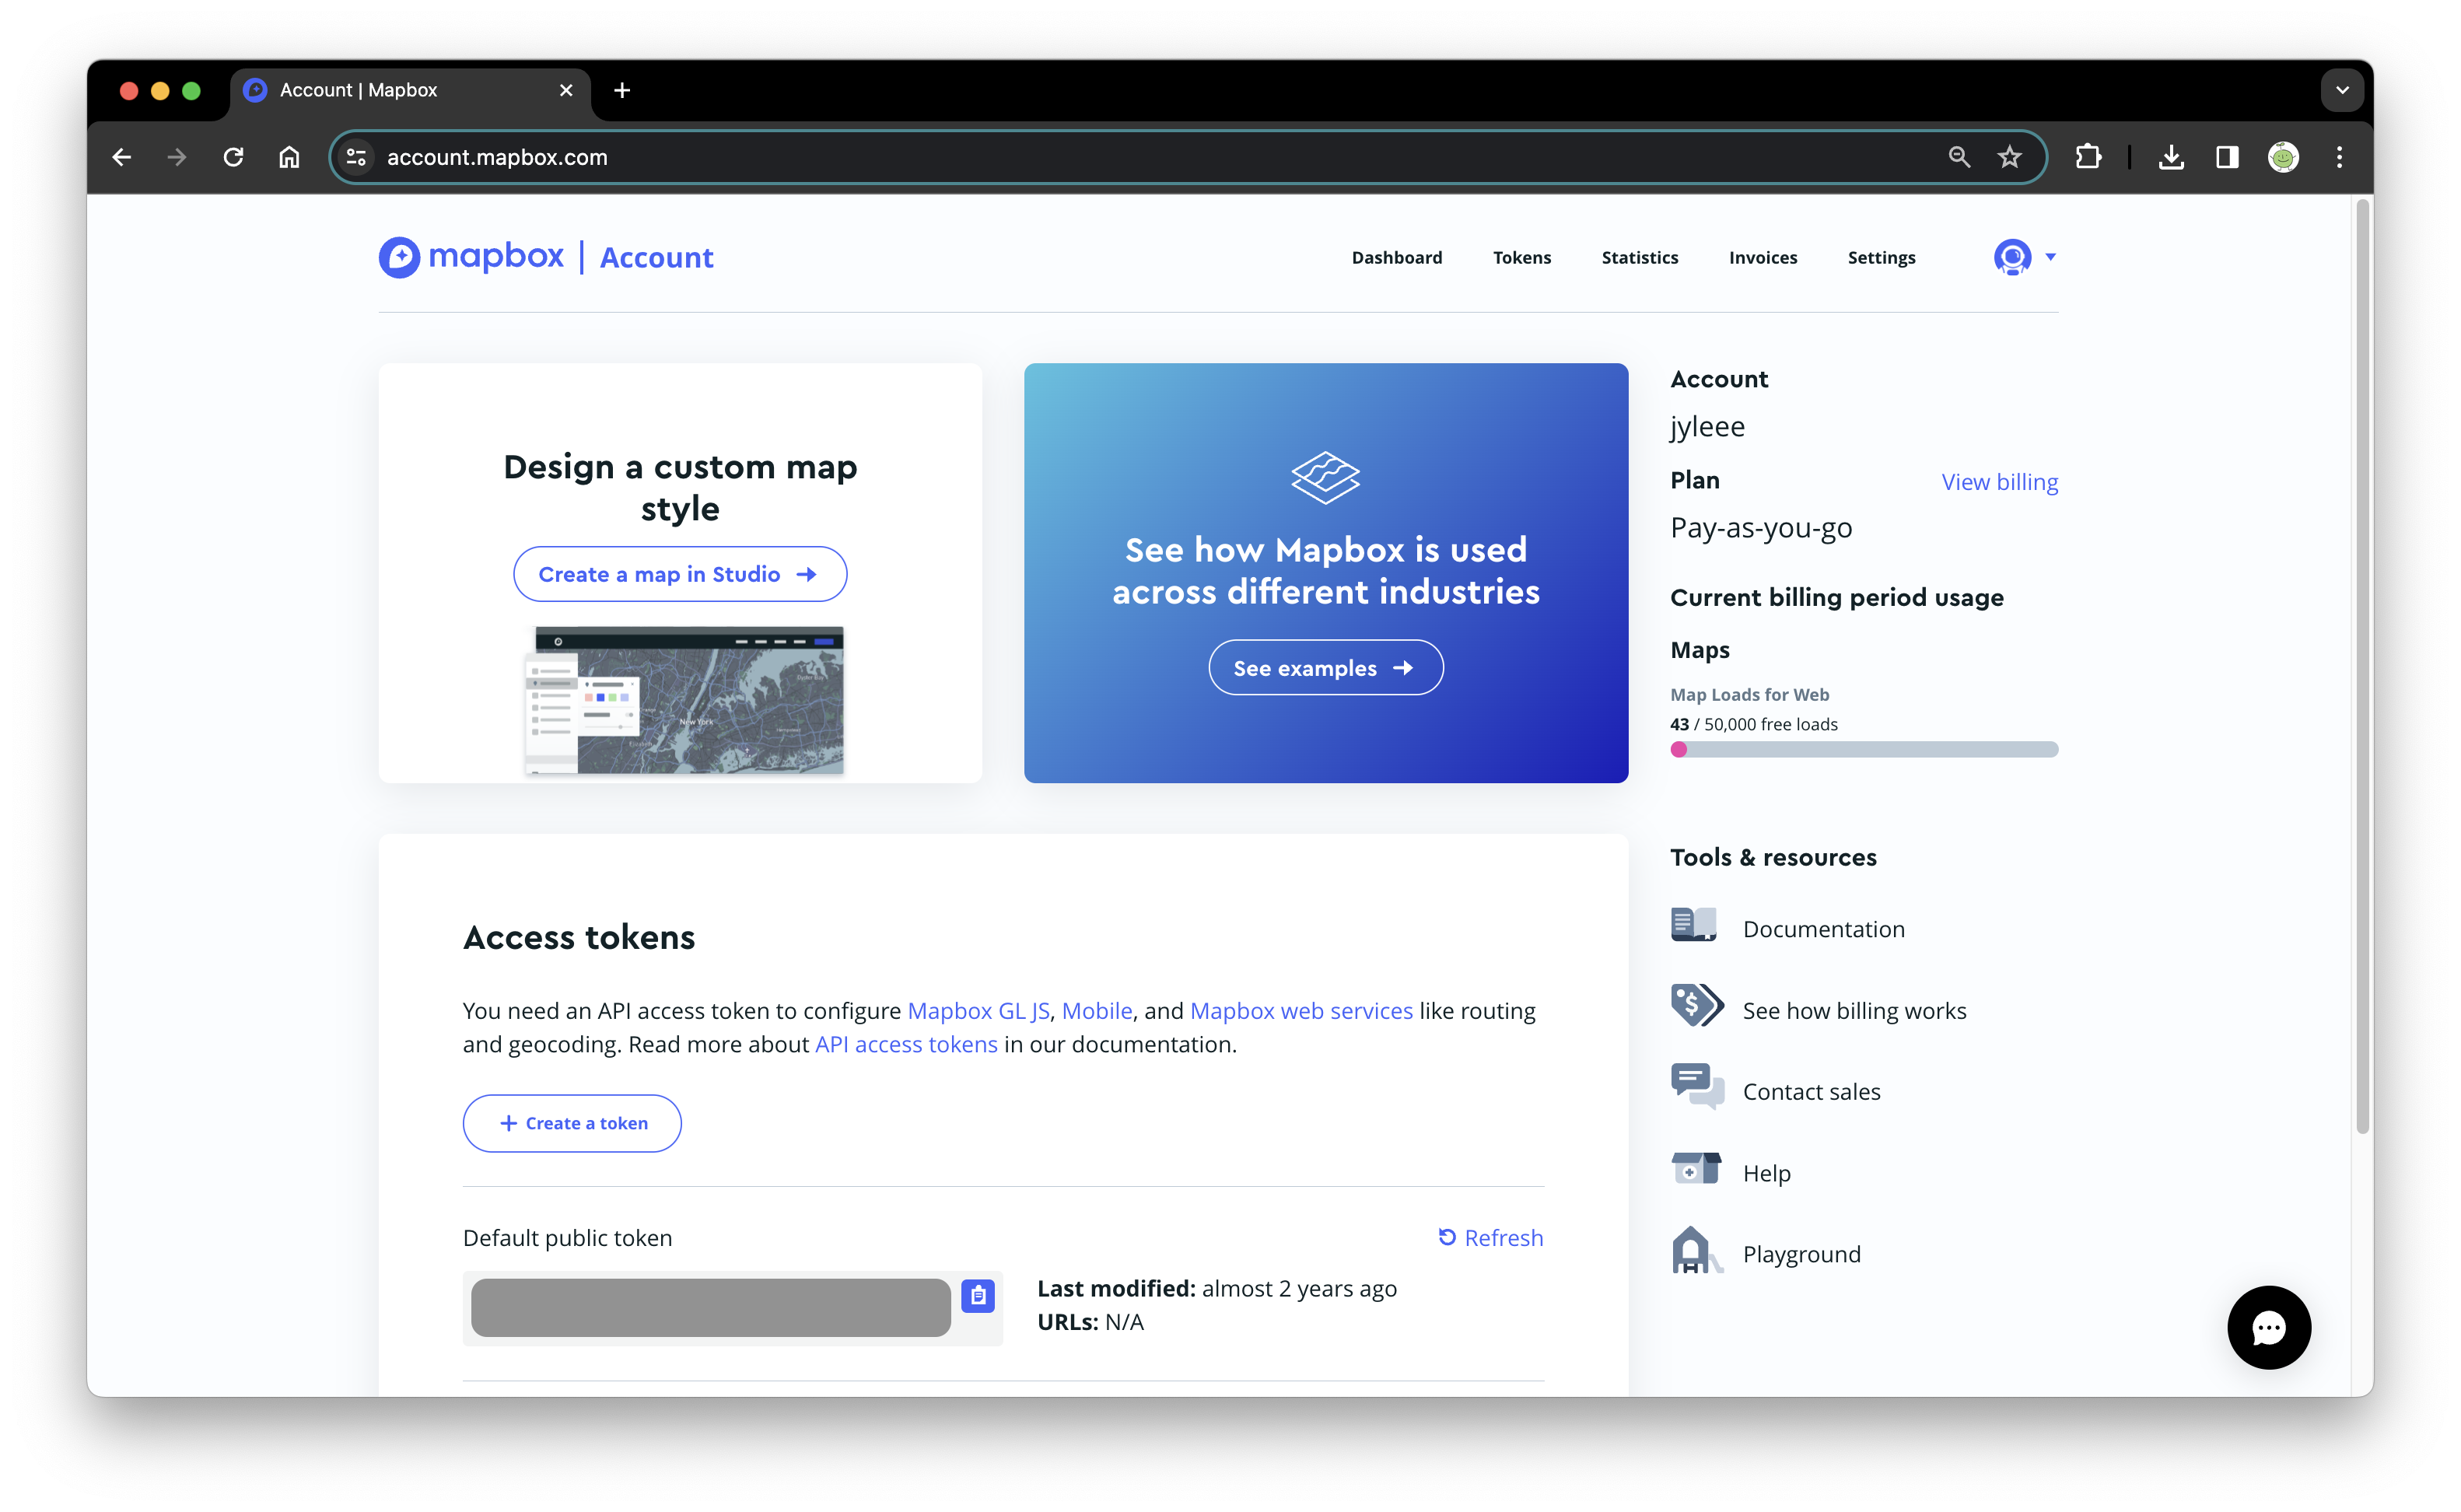
이번 장의 주요 목표는 분석 결과를 기반으로 지도 시각화를 수행하는 것이다. 이를 위해 지도 시각화 도구로 mapbox를 활용하며, 먼저 필요한 토큰을 발급받아야 한다. mapbox.com에 접속하여 회원가입을 완료한 후, Account 섹션으로 이동하면 위와 같은 화면을 확인할 수 있다. Mapbox는 특정 사용량 범위 내에서는 무료로 제공되며, 한도를 초과할 경우 과금이 발생할 수 있으므로 사용량을 확인하면서 이용해야 한다. Python에서 mapbox를 활용할 때 필요한 토큰은 화면 하단의 'Default public token'에 나와 있다. 해당 토큰을 복사하여 아래의 지도 시각화 섹션에서 사용할 예정이다.
token = "본인 token"INFO
분석1의 결과를 분석2에서 사용하므로 순서대로 진행하는 것을 권장한다.
분석1. 인구 대비 도로명주소 개수
인구데이터 정제하기
인구데이터는 행정안전부에서 제공하는 행정동별 주민등록 인구 및 세대현황의 전체시군구현황 데이터를 사용한다. 데이터는 csv 혹은 xlsx 형식이다. 데이터를 불러온 뒤 데이터의 형태, 수정이 필요한 부분 확인 등 간단한 전처리를 진행한다.
# 데이터 불러오기
df_pop = pd.read_excel('202401_202401_population_month.xlsx', header=2)

# 중복 데이터 확인하기
df_pop[df_pop['행정기관'].duplicated(keep=False)]2024년 1월 기준으로 다운받은 데이터에 '세종특별자치시'는 행정기관코드가 다른 동일한 행이 중복으로 기재되어 있다. 행정표준코드관리시스템에서 확인해보면 세종특별자치시의 행정동코드는 '3611000000'이므로 올바르지 않은 행은 삭제한다.
df_pop = df_pop[df_pop['행정기관코드']!=3600000000]
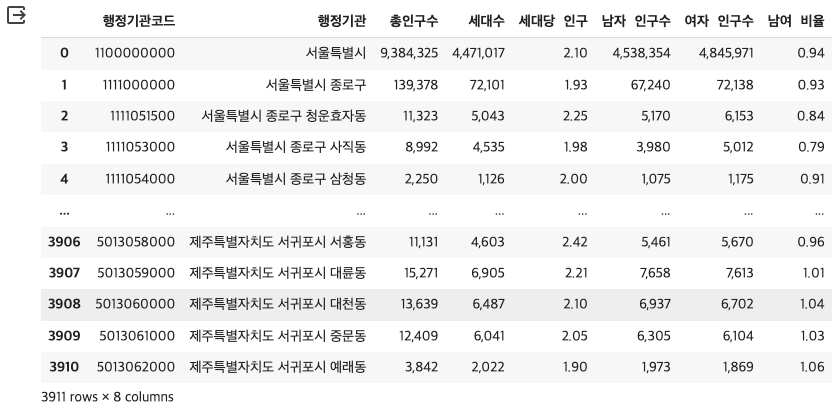
df_pop.reset_index(inplace=True, drop=True)정리한 최종 인구데이터는 다음과 같다. '서울특별시'와 같은 시도 단위와 '서울특별시 종로구'와 같은 시군구 단위의 데이터가 한 데이터 프레임 안에 있으므로, 추후 도로명주소 데이터와 함께 사용할 때 이 부분을 유의해야 한다.
인구 대비 도로명주소 개수 계산하기
인구 대비 도로명주소 개수를 계산할 때에는 '시도별'과 '시군구별'을 따로 진행한다. 계산을 위한 처리 과정은 두 경우 동일하므로 이 장에서는 시도별 인구 대비 도로명주소 개수를 계산하는 내용만 설명한다. 전체 내용은 코드에서 확인할 수 있다.
# 시도별 도로명주소 개수 데이터
sido = pd.DataFrame(df.groupby('시도명')["도로명주소관리번호"].count())
sido.reset_index(inplace=True)

# 시도별 인구수 데이터
df_pop['행정기관'] = df_pop['행정기관'].apply(lambda x:x.strip())
sido_pop = df_pop[df_pop['행정기관'].isin(list(sido['시도명']))].copy()첫 번째 작업은 도로명주소와 인구수 각각의 데이터프레임을 정리하는 것이다. sido는 시도별로 도로명주소 개수를 포함하는 데이터프레임이고 sido_pop은 17개 시도의 인구수를 포함하는 데이터프레임이다.
sido['시도명'] = sido['시도명'].apply(lambda x:x.strip()) # 좌우 공백 없애기
sido['도로명주소관리번호'] = sido['도로명주소관리번호'].astype(int) # int로 데이터 타입 바꾸기

sido_pop['행정기관'] = sido_pop['행정기관'].apply(lambda x:x.strip()) # 좌우 공백 없애기
sido_pop['행정기관코드'] = sido_pop['행정기관코드'].astype('str') # str로 데이터 타입 바꾸기
sido_pop['총인구수'] = sido_pop['총인구수'].str.replace(',', '').astype(int) # int로 데이터 타입 바꾸기두 번째로 두 데이터프레임을 합치기 전, 기준(PK)이 되는 컬럼은 동일한 값으로 인식될 수 있도록 좌우 공백을 없애고, 데이터 타입을 동일하게 수정한다. 인구 대비 도로명주소 개수를 계산할 때 필요한 '도로명관리번호' (도로명주소 개수) 컬럼과 '총인구수' 컬럼은 int로 바꿔준다.
# 하나의 데이터프레임으로 합치기
sido_address_pop = pd.merge(sido, sido_pop, left_on='시도명', right_on='행정기관')
sido_address_pop.drop('행정기관', axis=1,  inplace=True)
sido_address_pop.rename(columns={'도로명주소관리번호':'도로명개수'}, inplace=True)

# 인구 대비 도로명주소 개수 계산하기
sido_address_pop["인구 대비 도로명주소 개수"] = sido_address_pop.apply(lambda row: row["도로명개수"] / row["총인구수"], axis=1)
sido_address_pop마지막으로 sido와 sido_pop을 17개 시도명을 기준으로 하나로 합친 sido_address_pop를 정의한다. 이후, 인구 대비 도로명주소 개수를 계산한 컬럼을 추가한다.
시도별 인구 대비 도로명주소 개수의 값을 시각화하면 위와 같은 결과가 도출된다. '전라남도', '경상북도', '전북특별자치도' 등 순으로 인구 대비 도로명주소의 개수가 많다.
분석2. 면적 대비 도로명주소 개수
면적 계산하기
면적데이터는 주소기반산업지원서비스에서 제공하는 제공하는 주소 중 구역의 도형 2024년 1월 전체자료이다. 제공하는 주소는 신청서를 작성한 뒤 데이터를 제공받을 수 있다. (자세한 신청 방법은 3-5에서 확인할 수 있다.) 사이트에서 신청하여 받거나, 깃헙에 저장된 'geojson' 폴더를 다운받아 사용한다.
면적데이터는 시도 경계를 표현하는 파일과 시군구 경계를 표현하는 파일 두 개로 구분하여 제공한다. 두 데이터는 동일한 방법으로 처리를 진행하므로 본 글에서는 시도 데이터를 처리하는 방법만 소개하겠다. (시군구 처리 방법은 코드를 참고한다.)
# 해당 경로에서 'CTPRVN.shp'로 끝나는 모든 파일 불러오기
sido_file_list = glob.glob('geojson/*/*_CTPRVN.shp')

sido_geojson = pd.DataFrame()

# 모든 파일 geopandas로 불러오고 하나의 df로 합쳐주기
for file in tqdm(sido_file_list):
    df_tmp = gpd.read_file(file, encoding="cp949")
    sido_geojson = pd.concat([sido_geojson, df_tmp])

sido_geojson.columns = ["code", "eng_nm", "kor_nm", "geometry"]
sido_geojson["code"] = sido_geojson["code"].apply(lambda x: str(x) + "00000000")
sido_geojson.reset_index(inplace=True, drop=True)

print(sido_geojson.shape)
sido_geojson.head()데이터는 시도별로 구분하여 shp(Shapefile)포맷으로 제공한다. shp형식은 지리 정보 시스템 소프트웨어를 위한 지리 공간 벡터 데이터 형식을 의미한다. python에서 편리한 데이터 조작을 위해 shp 파일을 geopandas를 통해 읽어오고, 데이터프레임으로 정의한다. 이후 컬럼명을 부여하고 코드는 행정동코드와 같은 형식이 되도록 수정한다. 데이터프레임으로 정리한 시도 면적데이터 예시는 다음과 같다.
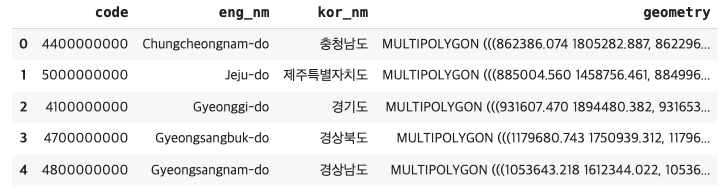
POLYGON은 다수의 선분들이 연결되어 닫혀 있는 상태인 다각형을 의미하고 MULTIPOLYGON은 다수 개의 POLYGON의 집합을 의미한다. 즉 행정구역의 경계를 나타내는 값이며, 이 정보로 행정구역별 면적을 계산할 수 있다.
def cal_area(df1):
  df1['code'] = df1['code'].astype('str') # str로 데이터 타입 바꾸기

  # 면적 계산하기
  df1 = df1.set_crs(epsg=5179, allow_override=True)
  df1["면적"] = df1["geometry"].area
  return df1

sido_geojson = cal_area(sido_geojson)면적 대비 도로명주소의 개수를 계산하기 위해서는 구역의 경계 데이터를 기반으로 각 행정구역 별 '면적'을 알아야 한다. 이때 설정하는 CRS(Coordinate Reference System)는 좌표계로, 곡면인 지구의 표면을 2차원의 평면으로 표현하는 방법을 의미한다. CRS의 유형은 epsg:4326, epsg:5179, epsg:4004 등이 있는데, 유형이 다른 데이터의 경우, 좌표간의 거리나 위치 등이 다르게 표현되므로 반드시 통일해야 한다. (이때 epsgs는 European Petroleum Survey Group의 약자로, 좌표계와 관련된 표준 데이터 베이스를 의미하며 CRS에 관한 자세한 설명은 이 문서를 참고한다.)
구역의 도형 데이터의 CRS는 epsg:5179로 설정되어 있으므로(참고), 이에 맞춰 데이터프레임의 좌표계를 설정해준다. 이후 '면적' 컬럼을 추가하여 내장함수를 통해 면적을 계산해주고 인구 대비, 면적 대비 도로명주소 개수를 계산한다.
면적 대비 도로명주소 개수 계산하기
면적 대비 도로명주소 개수를 계산할 때 역시 '시도별'과 '시군구별'을 따로 진행하며, 이 장에서는 시군구별 면적 대비 도로명주소 개수를 계산하는 내용만 다루도록 한다. 전체 내용은 코드를 참고한다.
def cal_area_per_road(df1, df2):
  df_total = df1.merge(df2, left_on='행정기관코드', right_on='code', how='outer')
  df_total["면적 대비 도로명주소 개수"] = df_total.apply(lambda row: row["도로명개수"] / row["면적"], axis=1)
  return df_total

# 시군구별
sigungu_total = cal_area_per_road(sigungu_address_pop, sigungu_geojson)sigungu_geojson과 sigungu_address_pop을 합친 sigungu_total을 정의한 뒤, 면적 대비 도로명주소 개수를 계산한 컬럼을 추가한다.
# 누락된 세종시 데이터 추가하기
sigungu_total.loc[251] = sido_total[sido_total['시도명'] == '세종특별자치시'].iloc[0]
sigungu_total['전체 시군구명'][251] = '세종특별자치시'
sigungu_total세종특별자치시의 경우 시군구 데이터가 없으므로, 지도 시각화를 진행했을 때 빈 값으로 표시되지 않도록 시도 데이터를 기반으로 시군구 데이터를 추가해준다.
위 그래프는 시군구별 면적 대비 도로명주소 개수가 많은 상위 20개 지역을 나타낸 것이다. '부산광역시 중구', '대구광역시 중구', '부산광역시 동구' 등 순으로 면적 대비 도로명주소 개수가 많다.
최종 지도 시각화
지금까지 처리한 데이터로 진행할 수 있는 지도 시각화는 크게 네 종류 이다.
- 시도별 인구 대비 도로명주소 개수
- 시군구별 인구 대비 도로명주소 개수
- 시도별 면적 대비 도로명주소 개수
- 시군구별 면적 대비 도로명주소 개수
지도 시각화를 진행하는 방법은 모두 동일하므로, 다양한 결과를 볼 수 있도록 이 장에서는 '1. 시도별 인구 대비 도로명주소 개수'와 '4. 시군구별 면적 대비 도로명주소 개수'만 진행하겠다. 전체 결과는 코드에서 확인할 수 있다.
시도별 인구 대비 도로명주소 개수
gdf_sido = gpd.GeoDataFrame(sido_total)

# mapbox에 맞춰 좌표계 변환
gdf_sido = gdf_sido.to_crs(epsg=4326)

gdf_sido.to_csv('sido-viz.csv', encoding='utf-8')
gdf_sido.to_file('sido-geoj.geojson', driver="GeoJSON")

gdf_sido.info()시각화를 진행하기 전에, mapbox는 CRS를 epsg:4326으로 사용하므로 이에 맞춰 좌표계를 변환해준다. (참고) CRS를 변환하지 않고 시각화를 진행하면 제대로 지도가 그려지지 않으니 반드시 맞춰줘야 한다. 이후, 데이터프레임을 csv와 geojson 파일로 저장한다.
gdf_sido = pd.read_csv('sido-viz.csv', encoding='utf-8')
geo_data_sido = 'sido-geoj.geojson'

with open(geo_data_sido, 'rt', encoding='utf-8') as f_sido:
gj_sido = geojson.load(f_sido)저장한 csv와 geojson 파일을 불러온다.
viz = ChoroplethViz(data=gj_sido,
                    color_property='인구 대비 도로명주소 개수',
                    access_token=token,
                    color_stops=create_color_stops([0, 0.05, 0.1, 0.15, 0.2, 0.4], colors='BuPu'),
                    color_function_type='interpolate',
                    line_stroke='--',
                    line_color='rgb(128,0,38)',
                    line_width=1,
                    line_opacity=0.9,
                    opacity=0.8,
                    center = (128, 36),
                    zoom=6,
                    below_layer='waterway-label',
                    legend_layout='horizontal',
                    legend_key_shape='bar',
                    legend_key_borders_on=False)
viz.show()지도 시각화 중 Choropleth 라는 면적에 지정한 값에 따라 다양한 색상과 스타일로 시각화하여 지도 위에 나타내며, 데이터의 패턴이나 특징을 빠르게 이해할 수 있도록 하는 시각화를 진행할 예정이다. 위 코드에서 중요 파라미터를 하나씩 살펴보겠다.
data: 시각화하고자 하는 지리적 데이터가 저장된 변수를 지정한다.color_property: 시각화에서 사용할 색상의 기준이 되는 데이터 속성을 설정한다.access_token=token: Mapbox에서 제공하는 API 토큰을 지정하여 지도를 불러올 때 인증에 사용한다.color_stops: 시각화에 사용할 색상의 범위를 정의한다. 데이터의 최소값, 최대값, 중앙값 등을 고려하여 값을 지정하면 되며 뒤에 지정한 색상 'BuPu'는 파란색에서 보라색으로 그라데이션된 색상을 나타낸다.line_stroke='--', line_color='rgb(128,0,38)', line_width=1, line_opacity=0.9: 지도의 경계를 나타내는 선의 스타일과 속성을 설정한다.opacity: 전체 시각화의 투명도를 설정한다.center = (128, 36), zoom=5.5: 지도의 초기 중심 위치와 확대 수준을 설정한다. 이 경우 대한민국의 중심 좌표를 지정한다.below_layer='waterway-label': 시각화가 지도의 어떤 레이어 아래에 표시될지를 설정한다. 여기서는 'waterway-label' 레이어 아래에 표시된다.legend_layout='horizontal', legend_key_shape='bar', legend_key_borders_on=False:- 범례의 레이아웃 및 모양을 설정한다.
시도별 인구 대비 도로명주소의 개수를 살펴보면 '서울', '경기', '부산', '대구', '세종' 등 특별시, 광역시, 특별자치시와 같이 비교적 인구가 많은 지역은 연한색으로 나타난다. 즉, 인구 대비 도로명주소의 개수가 적은 것을 의미한다. 앞서 4.3에서 시도별 도로명주소 개수를 확인했을 때, '세종', '울산', '대전'은 도로명주소의 개수가 가장 적은 하위 3개 시도였다는 것을 고려하면, 이 경우 인구수는 많지만 도로명주소의 개수는 적어 인구 대비 도로명주소의 개수가 적다는 것을 알 수 있다.
# 맵을 -15도 만큼 좌우 회전하고, 45도 만큼 상하 회전한다.
viz.bearing = -15
viz.pitch = 45

# 각 데이터에 '인구 대비 도로명주소 개수'를 기준으로 height 값을 준다.
viz.height_property = '인구 대비 도로명주소 개수'

## 높이의 값
numeric_stops = create_numeric_stops([0, 0.05, 0.1, 0.15, 0.2, 0.4], 0, 10000)

viz.height_stops = numeric_stops
viz.height_function_type = 'interpolate'

html = open('person_per_address_3d.html', "w", encoding="UTF-8")
html.write(viz.create_html())
html.close()

viz.show()동일한 시각화에서 각 면적의 height를 지정하는 등의 추가 파라미터를 지정하면 입체적인 지도 시각화를 생성할 수 있다.
시군구별 면적 대비 도로명주소 개수
이번에는 시군구별 면적 대비 도로명주소 개수를 시각화해보겠다. 좌표계 변환, csv, geojson 파일로 저장한 뒤, 불러오는 과정까지는 위와 동일한 방법으로 진행한다. 시각화를 진행할 땐, data 부분에 지정되는 값, color_property에 지정되는 컬럼명, 그리고 color_stops에 지정되는 색상 범위를 데이터에 맞게 변경한다.
viz = ChoroplethViz(data=gj_sigungu,
                    color_property='면적 당 도로명주소 개수',
                    access_token=token,
                    color_stops=create_color_stops([0, 0.0001, 0.00015, 0.0002, 0.00025, 0.003], colors='YlGnBu'),
                    color_function_type='interpolate',
                    line_stroke='--',
                    line_color='rgb(128,0,38)',
                    line_width=1,
                    line_opacity=0.9,
                    opacity=0.8,
                    center = (128, 36),
                    zoom=5.5,
                    below_layer='waterway-label',
                    legend_layout='horizontal',
                    legend_key_shape='bar',
                    legend_key_borders_on=False)

html = open('sigungu_area_per_address.html', "w", encoding="UTF-8")
html.write(viz.create_html())
html.close()

viz.show()